

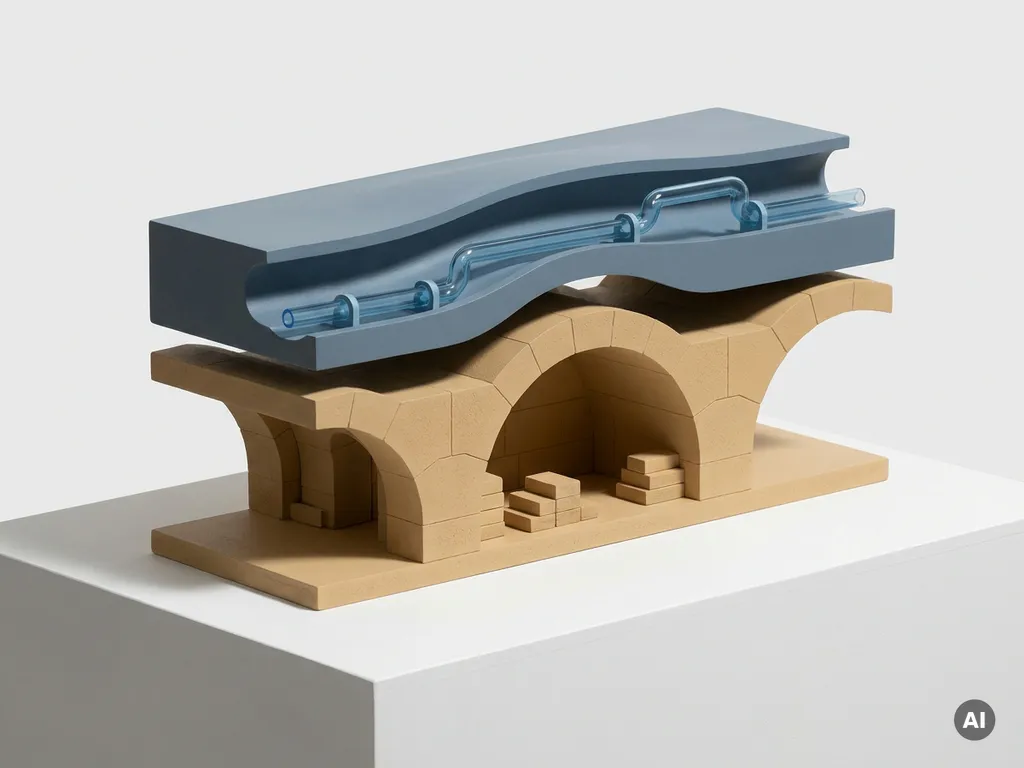
Een integratielaag en een opslaglaag zijn twee fundamenteel verschillende onderdelen van een data-architectuur. De integratielaag verplaatst en bewerkt data tussen systemen, terwijl de opslaglaag die data op een gestructureerde manier bewaart voor later gebruik. Beide lagen vervullen een eigen rol en zijn in de meeste serieuze data-omgevingen allebei nodig. In dit artikel beantwoorden we de meest gestelde vragen over het verschil tussen beide lagen en hoe ze samenwerken.
Welke taken voert een integratielaag uit in een datasysteem?
Een integratielaag is verantwoordelijk voor het ophalen, omzetten en doorsturen van data tussen verschillende bronsystemen. De laag fungeert als de verbindende schakel in een data-architectuur: hij haalt gegevens op uit systemen als een ERP, CRM of financiële applicatie, bewerkt die data onderweg waar nodig en levert ze af op de juiste bestemming. De integratielaag raakt de data, maar bewaart ze niet zelf.
Concreet voert een integratielaag taken uit zoals:
- Data ophalen uit meerdere bronsystemen via connectoren of API’s
- Velden hernoemen, filteren of samenvoegen zodat data uit verschillende bronnen op elkaar aansluit
- Foutafhandeling inregelen, zodat een probleem met één record de rest van de datastroom niet blokkeert
- Data op gezette tijden of in real time doorsturen naar de volgende stap in de keten
Een integratielaag is vergelijkbaar met een logistiek systeem: hij zorgt dat pakketten van A naar B komen, maar slaat ze niet zelf op in een magazijn. Hoe robuust die logistiek is, bepaalt in grote mate de betrouwbaarheid van de rest van de data-omgeving.
Wat doet een opslaglaag precies anders dan een integratielaag?
Een opslaglaag bewaart data op een gestructureerde manier voor duurzaam gebruik, analyse en rapportage. Waar de integratielaag data in beweging brengt, zorgt de opslaglaag dat data op een vaste, georganiseerde plek terechtkomt en beschikbaar blijft. De opslaglaag is de bestemming, niet de weg ernaartoe.
In de praktijk neemt een opslaglaag de data aan die de integratielaag aanlevert en legt die vast in een gestructureerd datawarehouse of een andere duurzame opslag. Vanuit die opslag kunnen rapportagetools, dashboards en analyseplatformen de data raadplegen zonder de bronsystemen te belasten.
Het grote verschil zit in de functie:
- De integratielaag is actief: hij verplaatst en transformeert data
- De opslaglaag is passief: hij bewaart en ontsluit data
Een opslaglaag werkt ook als buffer. Doordat data los wordt opgeslagen van de bronsystemen, kunnen die systemen gewoon blijven draaien zonder dat rapportagequeries of analyses hun prestaties beïnvloeden.
Waarom is de scheiding tussen beide lagen zo belangrijk?
De scheiding tussen de integratielaag en de opslaglaag is belangrijk omdat die beide lagen onafhankelijk van elkaar beheersbaar, aanpasbaar en schaalbaar maakt. Zonder die scheiding ontstaat al snel een situatie waarbij een aanpassing in de datastroom direct de opgeslagen data raakt, of waarbij een probleem in de opslag de hele integratie plattrekt.
Organisaties die werken met meerdere bronsystemen lopen zonder duidelijke scheiding al snel tegen een herkenbaar probleem aan: elk systeem geeft een ander antwoord op dezelfde vraag. Dat leidt tot twijfel over welk cijfer klopt en tot tijdverlies bij het handmatig afstemmen van data. Een heldere architectuur met gescheiden lagen voorkomt dat.
Daarnaast biedt de scheiding praktische voordelen:
- Flexibiliteit: je kunt een bronsysteem vervangen zonder de opslagstructuur te hoeven aanpassen
- Stabiliteit: de bronsystemen blijven ongestoord functioneren, ook als de opslaglaag wordt bijgewerkt
- Beheersbaarheid: fouten in de integratie zijn makkelijker te isoleren en op te lossen zonder de opgeslagen data aan te tasten
Hoe werken de twee lagen samen in de praktijk?
In de praktijk werken de integratielaag en de opslaglaag als een doorlopende keten: de integratielaag haalt data op uit bronsystemen, bewerkt die data en levert ze aan bij de opslaglaag, die de data vervolgens vastlegt en beschikbaar stelt voor analyse. Samen vormen ze de ruggengraat van een betrouwbare data-omgeving.
Een concreet voorbeeld: een organisatie werkt met een ERP-systeem voor voorraadbeheer en een CRM-systeem voor klantdata. De integratielaag haalt periodiek gegevens op uit beide systemen, herschrijft veldnamen zodat ze overeenkomen en stuurt de gecombineerde data door naar het datawarehouse. Vanuit dat datawarehouse haalt een rapportagetool als Power BI de gegevens op voor dashboards en managementrapportages.
Belangrijk in deze samenwerking is dat de twee lagen elkaar niet in de weg zitten. De integratielaag schrijft naar de opslaglaag, maar leest niet terug uit die opslaglaag voor zijn eigen werking. De opslaglaag leest niet uit de bronsystemen. Die duidelijke taakverdeling voorkomt onnodige afhankelijkheden en maakt de architectuur robuuster.
Wanneer heb je beide lagen nodig en wanneer volstaat één?
Je hebt beide lagen nodig zodra je met meerdere bronsystemen werkt en op basis van gecombineerde data wilt sturen of rapporteren. Als je data uit slechts één systeem gebruikt en geen historische vergelijkingen of gecombineerde analyses nodig hebt, kan een eenvoudigere opzet volstaan. Maar in de meeste organisaties met meer dan één bedrijfsapplicatie is een gecombineerde aanpak al snel noodzakelijk.
Een integratielaag alleen is voldoende als je data enkel van het ene systeem naar het andere wilt doorsturen en er niets mee hoeft te bewaren of analyseren. Denk aan een eenvoudige koppeling tussen een webshop en een boekhoudpakket.
Een opslaglaag alleen werkt als je data al in de juiste vorm aankomt, bijvoorbeeld via een handmatige export, en je die data alleen gestructureerd wilt bewaren en raadplegen.
Zodra er echter meerdere systemen betrokken zijn, data op verschillende momenten binnenkomt en rapportages over langere periodes nodig zijn, is de combinatie van beide lagen de enige duurzame oplossing. De integratielaag zorgt dan voor een betrouwbare aanvoer van data, en de opslaglaag zorgt dat die data consistent beschikbaar blijft voor analyse en besluitvorming.
Hoe wij helpen met data-architectuur
Bij Brander Company zien we dagelijks wat er misgaat als de integratielaag en de opslaglaag niet goed zijn ingericht of van elkaar zijn gescheiden. Onze aanpak BranderSPOT is precies gebouwd rond dit principe: een duidelijke scheiding tussen de laag die data verplaatst en de laag die data bewaart.
- BranderBUS is onze integratielaag: hij haalt automatisch data op uit bronsystemen zoals Exact, Grip, Dynamics 365 en andere applicaties, bewerkt de data onderweg en levert die betrouwbaar aan bij de volgende stap
- BranderDWH is onze opslaglaag: een apart datawarehouse waar alle data samenkomt en op elkaar wordt afgestemd, zonder dat de bronsystemen worden belast of aangetast
- Power BI maakt de data vervolgens zichtbaar als dashboards en rapportages waarop directies en managers kunnen sturen
- BranderBUS draait in een omgeving die de klant zelf beheert, zonder vendor lock-in bij een externe partij
- We vervangen geen bestaande systemen, maar verbinden ze slimmer met elkaar
Wil je weten of jouw huidige data-architectuur goed is ingericht, of wil je af van tegenstrijdige cijfers uit verschillende systemen? Neem contact met ons op en we kijken samen wat er nodig is.
Veelgestelde vragen
Hoe begin ik met het inrichten van een integratielaag en opslaglaag als mijn organisatie dat nog niet heeft?
Begin met een inventarisatie van je bronsystemen: welke applicaties gebruiken jullie, welke data komt daaruit en wat wil je uiteindelijk kunnen rapporteren? Breng daarna de gewenste datastromen in kaart voordat je technische keuzes maakt. Een veelgemaakte fout is direct beginnen met toolselectie zonder eerst de architectuur te hebben doordacht — dat leidt later tot dure aanpassingen.
Wat zijn de meest voorkomende fouten bij het inrichten van een data-architectuur met meerdere systemen?
De meest voorkomende fout is het samenvoegen van de integratie- en opslaglaag in één oplossing, bijvoorbeeld door transformatielogica direct in het datawarehouse te schrijven. Dit maakt de architectuur kwetsbaar: een wijziging in een bronsysteem kan dan direct de opgeslagen data beschadigen. Een tweede veelgemaakte fout is het ontbreken van foutafhandeling in de integratielaag, waardoor één foutief record de hele datastroom kan blokkeren.
Kan ik een bestaand systeem zoals Power BI of Excel gebruiken als opslaglaag?
Power BI en Excel zijn rapportage- en analysetools, geen opslaglagen. Ze zijn niet ontworpen om data duurzaam en gestructureerd op te slaan op een manier die schaalbaar is voor meerdere bronsystemen. Als je Power BI of Excel als primaire databron gebruikt, loop je al snel tegen beperkingen aan zoals trage prestaties, versieconflicten en inconsistente cijfers. Een dedicated datawarehouse als opslaglaag lost deze problemen structureel op.
Hoe weet ik of mijn huidige data-architectuur goed genoeg is ingericht?
Een betrouwbare indicator is de vraag: krijg je vanuit verschillende systemen of rapporten verschillende antwoorden op dezelfde vraag? Als ja, dan ontbreekt er waarschijnlijk een goed ingerichte opslaglaag die als enige bron van waarheid fungeert. Andere signalen zijn: rapportages die lang duren omdat ze direct op bronsystemen draaien, handmatig werk om data uit verschillende bronnen samen te voegen, of het ontbreken van historische vergelijkingen in je analyses.
Wat is het verschil tussen een integratielaag en een gewone API-koppeling?
Een API-koppeling is een technische verbinding tussen twee systemen, terwijl een integratielaag een volledige beheersomgeving is voor meerdere van dit soort koppelingen tegelijk. Een integratielaag voegt daar bovenop functies toe zoals foutafhandeling, logging, transformatielogica en planmatige uitvoering. Een losse API-koppeling volstaat voor een eenvoudige één-op-één verbinding, maar zodra je meerdere systemen beheert en betrouwbaarheid kritisch is, heb je een volwaardige integratielaag nodig.
Hoe zorg ik ervoor dat mijn bronsystemen niet worden belast door rapportages en analyses?
Dit is precies de reden waarom een aparte opslaglaag zo waardevol is. Door data periodiek uit je bronsystemen te halen via de integratielaag en op te slaan in een datawarehouse, kunnen rapportagetools zoals Power BI altijd vanuit die opslaglaag werken zonder directe verbinding met de bronsystemen. Zo blijven je ERP, CRM of andere bedrijfsapplicaties optimaal presteren, ongeacht hoeveel rapporten of dashboards er tegelijkertijd worden geraadpleegd.
Wat gebeurt er als een bronsysteem tijdelijk niet beschikbaar is — hoe gaat een goede architectuur daarmee om?
In een goed ingerichte architectuur heeft een tijdelijke storing in een bronsysteem geen directe impact op de rapportages en analyses van je organisatie. De opslaglaag bevat immers al de eerder aangeleverde data, zodat dashboards en rapporten gewoon beschikbaar blijven. De integratielaag registreert de mislukte poging, probeert het opnieuw zodra het bronsysteem weer beschikbaar is en zorgt zo voor een betrouwbare aanvoer zonder dataverlies.
Gerelateerde artikelen
- Kan een data-integratieplatform ook zonder externe cloud-dienst draaien?
- Wat is vendor lock-in en hoe voorkom je het bij data-integratie?
- Wat is de relatie tussen business intelligence en datagovernance?
- Hoe voorkom je veelgemaakte fouten bij business intelligence?
- Hoe vind je ontbrekende gegevens in een database met database recovery?